올해의 단어가 된 슬롭
Merriam-Webster는 2025년 올해의 단어로 slop을 골랐다. 1700년대에는 질척한 진흙을, 1800년대에는 돼지에게 주는 음식 찌꺼기를 가리키던 말이다. 사전은 이 말을 AI로 대량 생산한 질 낮은 디지털 콘텐츠라고 풀이한다.
Merriam-Webster가 그해의 슬롭으로 꼽은 것 중에는 동료의 시간을 잡아먹는 workslop 보고서도 있다. Stanford Social Media Lab과 BetterUp Labs 연구진이 2025년 9월 Harvard Business Review에 쓴 말이다. 잘한 일처럼 보이지만 일을 앞으로 나아가게 할 내용은 없는 AI 결과물을 가리킨다. 미국 사무직 1,150명을 설문했더니 40%가 지난 한 달 사이 이런 결과물을 받았다고 답했고, 한 건을 처리하는 데 평균 1시간 56분을 썼다고 했다.
연구진에 따르면 workslop을 받은 사람은 그걸 해석하고 고치고 때로는 처음부터 다시 해야 한다. 만든 사람이 덜 한 일을 받은 사람이 대신 한다.
코드에서도 같은 일이 일어난다. 이 글에서 말하는 코드 슬롭은 빌드와 테스트는 통과하지만 쓴 사람이 제대로 확인하지 않은 코드다. 그 확인은 리뷰어나 나중에 유지보수하는 사람이 대신 한다.
사람도 이런 코드를 쓴다. 다만 AI로는 훨씬 빨리, 많이 만들 수 있고 겉모양도 깔끔하다.
오픈소스가 먼저 막았다
공개 저장소는 누구나 PR을 올릴 수 있어서 이 문제를 먼저 겪었다. 2026년 상반기에만 이름이 알려진 프로젝트 몇 곳이 기여를 받는 방식을 바꿨다.
curl
curl은 2019년 4월부터 운영하던 버그 바운티를 2026년 1월 31일로 끝냈다. 7년 가까이 운영하면서 확인된 취약점 87건에 10만 달러 넘게 지급한 프로그램이다. 메인테이너 Daniel Stenberg에 따르면 2025년 전까지는 접수된 신고의 15% 넘게가 실제 취약점이었다. 2025년부터는 5%도 안 됐다.
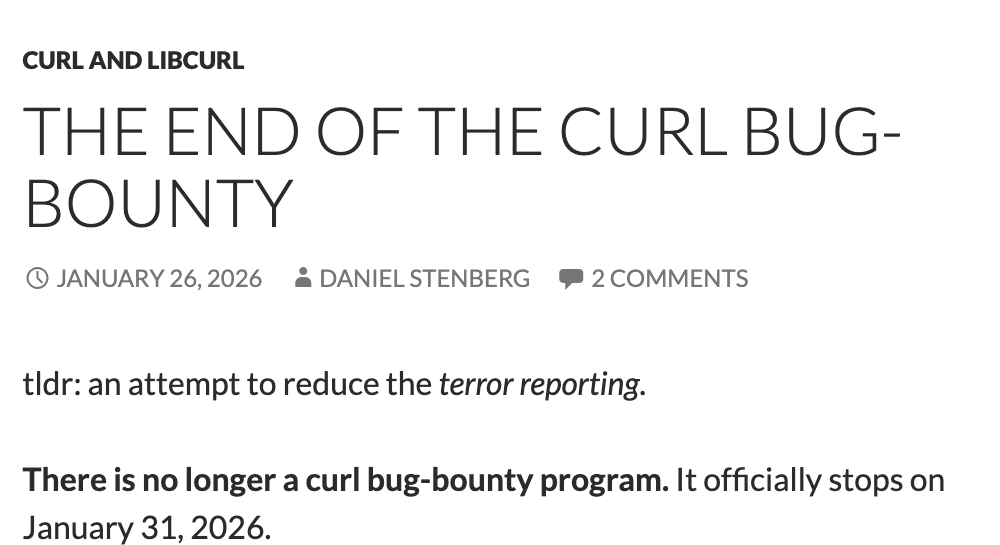
종료를 발표한 그 주에는 16시간 사이에 HackerOne 신고 7건이 들어왔다. 진짜 버그도 몇 건 있었지만 취약점은 하나도 없었다. Stenberg는 그럴듯한 신고를 반박하는 데 시간이 오래 걸리고 그 일이 보안팀에 큰 정신적 부담이 된다고 썼다. 돈을 주지 않으면 제대로 조사하지 않은 신고를 보낼 이유도 줄어든다는 판단이다. 취약점 신고는 GitHub의 비공개 신고 기능과 보안팀 이메일로 계속 받고 보상만 주지 않는다.
tldraw
캔버스 라이브러리 tldraw를 만든 Steve Ruiz는 2026년 1월 외부 기여자의 PR을 자동으로 닫기로 했다. 블로그 글에 그동안 받은 PR의 모양을 적어 두었다. 겉보기에 멀쩡했고 테스트와 검사도 통과해서 몇 개는 실제로 병합했다. 그런데 올린 사람들은 PR 템플릿을 무시했다. 코드는 코드베이스에 있는 패턴을 따르지 않았고 가져다 써야 할 코드를 그 자리에 다시 써 넣었다.
있지도 않은 버그를 고쳤다는 PR도 왔다. 거슬러 올라가 보니 Ruiz 자신이 AI 스크립트로 만든 이슈가 잘못돼 있었고, 다른 사람의 AI가 그 잘못된 이슈를 고쳤다고 PR을 올린 것이었다.
Ruiz는 tldraw 팀도 AI로 코드를 쓴다고 밝혔다. 다만 코드를 쓰는 일이 쉬워졌다면 굳이 외부 사람이 대신 써 줄 이유가 없다고 했다. 외부 기여자의 AI는 이슈가 말이 되는지 판단하는 단계를 건너뛰었고, 그 판단은 결국 메인테이너가 다시 해야 했다.
Ghostty
터미널 에뮬레이터 Ghostty는 AI 정책 문서를 따로 두었다. AI를 썼다면 형태와 상관없이 밝혀야 하고, PR을 올린 사람이 코드를 전부 이해하고 있어야 한다. 어기면 공개 명단에 올라 이후 기여가 막힌다. 문서는 AI에 반대해서 만든 규칙이 아니라고 적었다. 도구가 아니라 사람이 문제라는 것이다.
GitHub
GitHub도 저장소 설정을 늘렸다. 2월 13일에는 PR을 아예 끄거나 쓰기 권한이 있는 협업자만 PR을 열 수 있게 하는 설정이 생겼다. 6월 17일에는 쓰기 권한이 없는 사용자 한 명이 열어 둘 수 있는 PR 수에 상한을 두는 기능이 나왔다. 6월 변경 기록에 AI라는 말은 없다. 반복되는 저품질 기여와 드라이브바이 기여 때문에 분류가 늦어지고 리뷰 대기열이 넘친다고만 적었다.
숫자로 보면
7월에 arXiv에 올라온 논문 "AI Slop is DDoSing Open Source"는 저장소 294곳에서 200만 건이 넘는 PR과 이슈를 분석했다. 2025년에 PR 수는 늘었는데 병합되는 비율은 떨어졌다. 한 번만 기여하고 떠나는 사람의 PR은 시계열 모델로 예측한 값보다 병합률이 18.18% 낮았다. 제목은 그럴듯한 저품질 기여가 몰려서 커뮤니티가 감당할 수 있는 양을 넘기는 상황을 서비스 거부 공격에 빗댄 말이다.
세 프로젝트 모두 AI 사용 자체를 막지는 않았다. curl과 Ghostty는 이해하지 못한 채 보낸 신고와 코드를 받지 않겠다고 했고, tldraw는 외부 PR을 아예 닫았다.
코드로 보면 이런 모양이다
회사 코드베이스에서는 이런 코드가 PR 안의 함수 하나, 테스트 하나로 섞여 들어온다. 명백한 버그도 있지만 대부분은 하나씩 놓고 보면 틀렸다고 말하기 애매하다. 프론트엔드에서 자주 보는 모양을 몇 가지 적어 본다.
맞아 보이는데 틀린 코드
async function saveAll(items: Item[]) {
  items.forEach(async (item) => {
    await api.save(item);
  });
  return { ok: true };
}async와 await가 제자리에 있어서 비동기 처리를 제대로 한 것처럼 읽힌다. 그런데 forEach는 콜백이 돌려주는 Promise를 기다리지 않는다. 저장이 하나도 끝나지 않았을 때 { ok: true }가 반환되고, 저장이 실패해도 호출한 쪽은 알 수 없다. 타입 검사는 통과한다. 타입 정보를 쓰는 린트 규칙 no-misused-promises를 켜 둔 프로젝트에서만 잡힌다.
Dominic Elm이 정리한 코드 슬롭의 특징에서 첫 예로 든 코드도 이 모양이다. 저장을 기다리고 실패를 호출한 쪽에 넘기려면 이렇게 바꾼다.
await Promise.all(items.map((item) => api.save(item)));에러를 삼키는 방어 코드
async function fetchOrders(userId?: string): Promise<Order[]> {
  try {
    if (!userId) return [];
    const res = await fetch(`/api/users/${userId}/orders`);
    const data = await res.json();
    return Array.isArray(data?.orders) ? data.orders : [];
  } catch {
    return [];
  }
}
어떤 입력이 와도 터지지 않는다. 대신 사용자 ID가 비어 있을 때, 서버가 500을 돌려줄 때, 응답 모양이 바뀌었을 때, 네트워크가 끊겼을 때가 전부 주문이 없을 때와 똑같이 보인다. 화면에는 빈 목록이 뜨고 오류 추적 도구에는 아무것도 남지 않는다.
리뷰어는 여기서 따로 확인할 게 생긴다. userId가 정말 비어서 들어오는 경로가 있는지. 이 빈 배열을 받아서 "주문 내역이 없습니다"를 띄우는 화면이 있는지. 그런 화면이 있다면 서버 오류가 나도 사용자는 주문이 없다는 안내를 보고, 개발자는 문의가 들어온 뒤에야 문제를 안다.
파생 상태를 effect로 맞추기
const [visible, setVisible] = useState<Todo[]>([]);

useEffect(() => {
  setVisible(todos.filter((t) => t.done === showDone));
}, [todos, showDone]);todos와 showDone으로 계산할 수 있는 값을 state에 따로 넣고 effect로 맞춘다. 첫 렌더링에는 빈 목록이 그려지고, effect가 돈 뒤에 한 번 더 렌더링된다. React 문서 You Might Not Need an Effect는 첫 예로 이런 코드를 들고 렌더링 중에 계산하라고 한다.
const visible = todos.filter((t) => t.done === showDone);이 문서보다 오래된 React 코드가 훨씬 많다. 모델이 공식 문서보다 많이 본 코드 쪽으로 돌아가는 이유는 AI가 옛날 지식을 못 버리는 이유에 따로 적었다. 최신 eslint-plugin-react-hooks는 effect 안에서 바로 state를 바꾸면 알려주는 set-state-in-effect 규칙을 권장 설정에 넣어 두었다. 플러그인을 최신으로 올린 프로젝트라면 이 코드는 린트에서 걸린다.
이미 있는 걸 또 만든다
// src/lib/format.ts 에는 이미 formatPrice가 있다
const toWon = (n: number) => `${n.toLocaleString("ko-KR")}원`;
새 함수 자체는 틀리지 않았다. 다만 이제 가격을 표시하는 규칙이 두 군데에 있다. 나중에 "0원은 무료로 표시" 같은 요구가 들어오면 한 군데만 고쳐지고 화면마다 가격이 다르게 보인다. tldraw가 받은 PR도 이런 식으로 있는 코드를 가져다 쓰지 않았다.
GitClear의 2025년 보고서는 2020년부터 2024년까지 바뀐 코드 2억 1100만 줄을 분석했다. 2024년은 복사해 붙인 줄이 옮긴 줄보다 많아진 첫해였다. 옮긴 줄은 보통 리팩터링에서 나온다. 5줄 이상 중복된 코드 블록은 2024년 한 해 동안 8배로 늘었다. GitClear는 코드 분석 도구를 파는 회사이고 분석한 코드는 자사 고객의 저장소와 오픈소스 프로젝트에서 나왔다. 이 데이터로 AI 도구가 원인이라고 말할 수는 없다. 같은 시기에 같이 늘었을 뿐이다.
아무것도 확인하지 않는 테스트
it("쿠폰 할인을 적용한다", () => {
  const total = applyDiscount(cart, coupon);
  expect(total).toBeGreaterThanOrEqual(0);
});
Michael Bromley가 The Problem With Your AI Tests에서 AI가 쓴 테스트의 예로 든 코드와 같은 모양이다. 할인율을 잘못 계산해도 이 테스트는 통과한다. 테스트 수가 늘고 커버리지도 오르지만 할인이 맞게 계산됐는지는 확인하지 않는다.
구현과 테스트를 같은 요구사항 해석에서 만들면 둘이 같은 실수를 공유할 수도 있다. Elm도 같은 계획을 받은 에이전트 두 개가 같은 실수에 동의할 수 있다고 적었다.
화면에도 있다
Anthropic은 2025년 11월 글에서 지침 없이 랜딩 페이지를 만들게 하면 거의 항상 Inter 글꼴, 흰 바탕에 보라색 그라데이션, 최소한의 애니메이션이 나온다고 썼다. 학습 데이터에는 누구에게나 무난한 디자인이 가장 많고 모델은 확률이 높은 쪽을 고른다. Anthropic은 이걸 distributional convergence라고 불렀다.
위의 코드 예시도 대부분 어디서나 흔히 보는 모양이다. 첫 번째 예를 빼면 다른 프로젝트에서는 문제없이 돌아갈 수도 있는 코드다. 이 프로젝트에 맞는지는 아무도 확인하지 않았다.
리뷰에서 잘 안 걸리는 이유
위 코드는 모두 빌드와 타입 검사를 통과하고, 테스트가 허술하면 테스트도 통과한다. 린트는 두 가지만 잡는데 그것도 해당 규칙을 켜 둔 프로젝트에서만 잡는다. 나머지는 사람이 읽어서 찾아야 한다.
자동 검사가 촘촘한 프로젝트는 사정이 다르다. curl은 신고 때문에 바운티를 접었지만 PR에서는 아직 AI 슬롭이 문제가 되지 않았다고 1월 공지에 적었다. Stenberg는 도구와 테스트, 스캐너로 PR을 자동으로 걸러 낼 수 있고 CI 작업 200개를 모두 통과하기 전에는 사람이 PR을 볼 필요가 없다고 썼다. 위 예시로 치면 첫 번째 코드는 저장 실패를 흉내 낸 테스트 하나로 잡힌다. 에러를 삼키는 코드는 누군가 서버 오류 상황을 떠올려 테스트를 써야 잡히고, 중복 유틸은 테스트로 잡을 수 없다.
예전에는 대충 쓴 코드가 겉모양에서 티가 났다. 이름이 엉성하거나 들여쓰기가 어긋나 있거나 예외 처리가 아예 없었다. 리뷰어는 그런 단서를 보고 어디를 꼼꼼히 볼지 정했다. AI가 쓴 코드는 이름이 그럴듯하고 타입이 붙어 있고 주석까지 달려 있어서 겉모양으로는 어디를 의심할지 알기 어렵다. Ruiz도 대충 한 작업이 쉽게 티 나던 때와 달리 지금은 나쁜 작업과 좋은 작업을 거의 구별할 수 없다고 썼다.
만드는 데 드는 시간과 읽는 데 드는 시간도 크게 다르다. 300줄짜리 변경을 만드는 데 1분이 걸렸다고 그걸 읽는 데도 1분이 걸리지는 않는다. 나머지 시간은 리뷰어가 쓴다.
AI를 쓴 사람이 자기 작업 속도를 거꾸로 느꼈다는 실험도 있다. METR가 2025년 상반기에 진행한 실험이다. 크고 복잡한 오픈소스 저장소에서 평균 5년을 일한 개발자 16명에게 실제 이슈 246개를 맡기고, 이슈마다 AI를 써도 되는지를 무작위로 정했다. 개발자들은 작업 전에 AI 덕분에 24% 빨라질 거라고 예상했고, 끝난 뒤에도 20% 빨라졌다고 믿었다. 측정해 보니 AI를 쓴 이슈가 19% 더 오래 걸렸다.
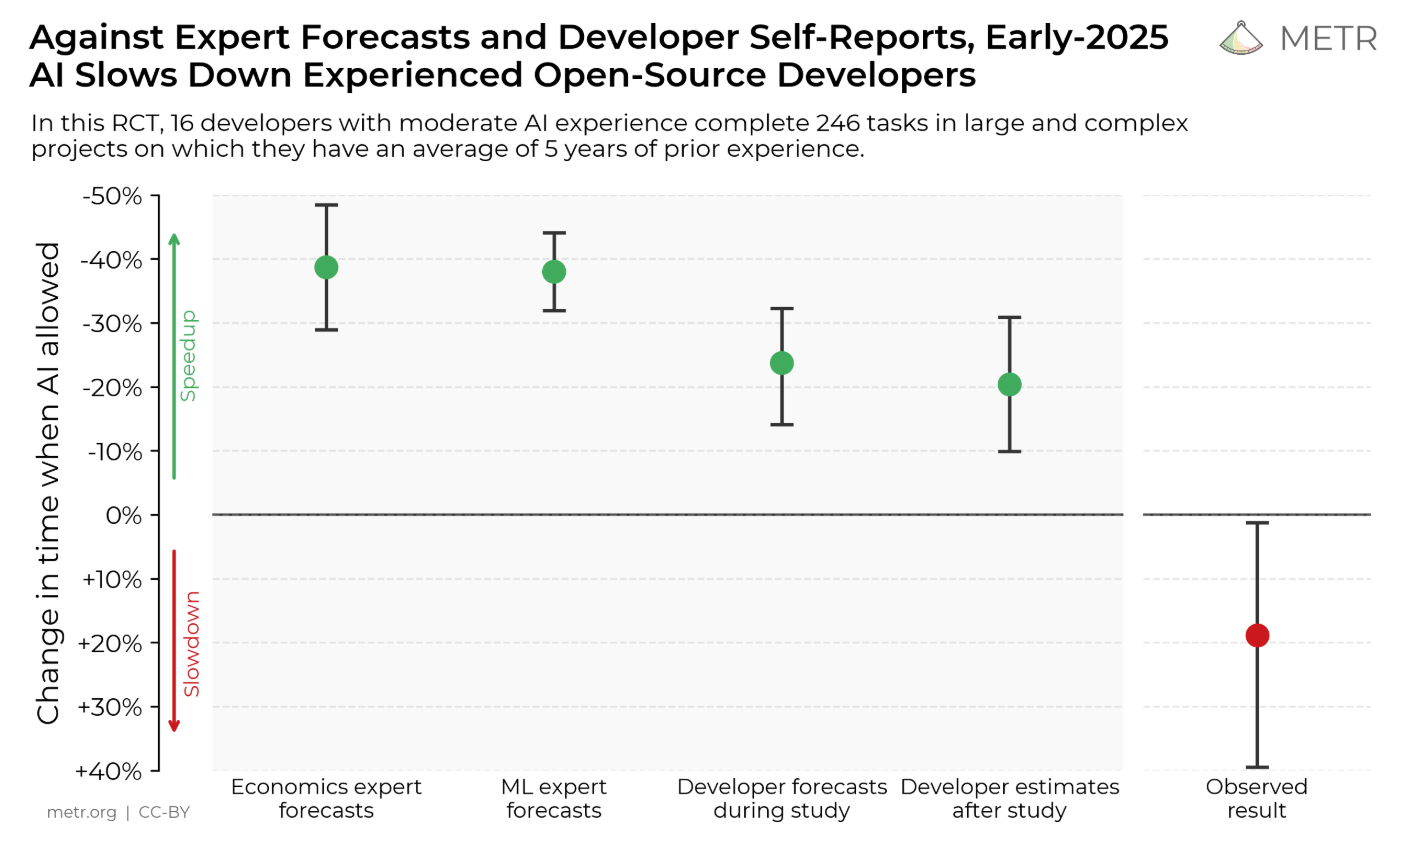
이 결과를 AI를 쓰면 느려진다는 뜻으로 읽으면 안 된다. 2025년 초의 도구였고, METR도 2026년 2월에 지금은 개발자들이 그때보다 더 빨라졌을 가능성이 높다고 적었다. 그래도 개발자들이 걸린 시간조차 반대로 짚었다는 점은 그대로다. 코드가 맞는지는 걸린 시간보다 훨씬 알기 어렵다.
무엇을 바꾸나
curl은 이해하고 재현할 수 있는 신고만 보내라고 했고 Ghostty는 이해하지 못한 코드를 받지 않기로 했다. 둘 다 확인하는 일을 기여자에게 다시 맡겼다. 팀 안에서도 같은 방향으로 할 수 있는 일이 있다.
설명할 수 없는 줄은 받지 않는다. 리뷰에서 "이 분기는 언제 타나요?"라고 물었을 때 답이 없으면 그 코드는 지운다. Ghostty가 외부 기여자에게 요구하는 것과 같은 기준이다. 앞에서 본 방어 코드나 중복 유틸은 이 질문으로 걸러낼 수 있다.
PR을 작게 나눈다. 읽는 데 드는 시간이 만드는 데 드는 시간보다 한참 길어지면 리뷰어는 훑어보고 승인하기 쉽다. 작게 나누면 한 번에 읽을 수 있는 양이 된다.
테스트는 고치기 전에 실패하는지 본다. 버그를 고치는 PR이라면 고치기 전 코드에서 그 테스트가 실패해야 한다. 테스트를 먼저 정해 승인하고 구현하는 에이전트가 그 테스트를 고치지 못하게 막는 방법도 있다. 뮤테이션 테스트를 돌리면 테스트가 실제로 뭔가를 잡는지 확인할 수 있다.
반복되는 모양은 규칙으로 만든다. 위 예시 중 두 개는 이미 린트 규칙이 있다. 린트로 못 잡는 것, 그러니까 프로젝트에 이미 있는 유틸 목록이나 에러를 어디서 잡아서 어디로 보내는지 같은 규칙은 에이전트가 읽는 문서에 적어 둔다. 하네스 엔지니어링에서 쓴 것처럼 새로운 일은 아니다. 원래 새로 온 팀원에게 알려 주던 내용이다.
누가 확인했는가
코드만 보고 AI가 썼는지 가려내기는 어렵다. 사람이 쓴 코드에도 같은 모양이 있다. Ruiz도 AI 코드를 알아보는 방법에 쏠린 논의는 핵심을 놓쳤다고 했다. 대신 PR을 올린 사람이 그 코드를 확인했는지는 물어볼 수 있다.
curl과 Ghostty는 이 질문을 기여자에게 돌려줬고 tldraw는 외부 PR을 아예 닫았다. 팀 안에서는 리뷰어가 같은 질문을 PR마다 할 수 있다.